
Declaration officielle
Autres déclarations de cette vidéo 4 ▾
- 0:38 Pourquoi le CDN provoque-t-il un pic de crawl dangereux pour le serveur d'origine ?
- 2:15 Le CDN influence-t-il réellement la vitesse de crawl de Googlebot ?
- 3:19 Pourquoi le premier remplissage du cache CDN peut-il plomber votre serveur d'origine ?
- 7:13 Faut-il vraiment renvoyer un code 429 ou 500 pour contrôler le crawl de Google ?
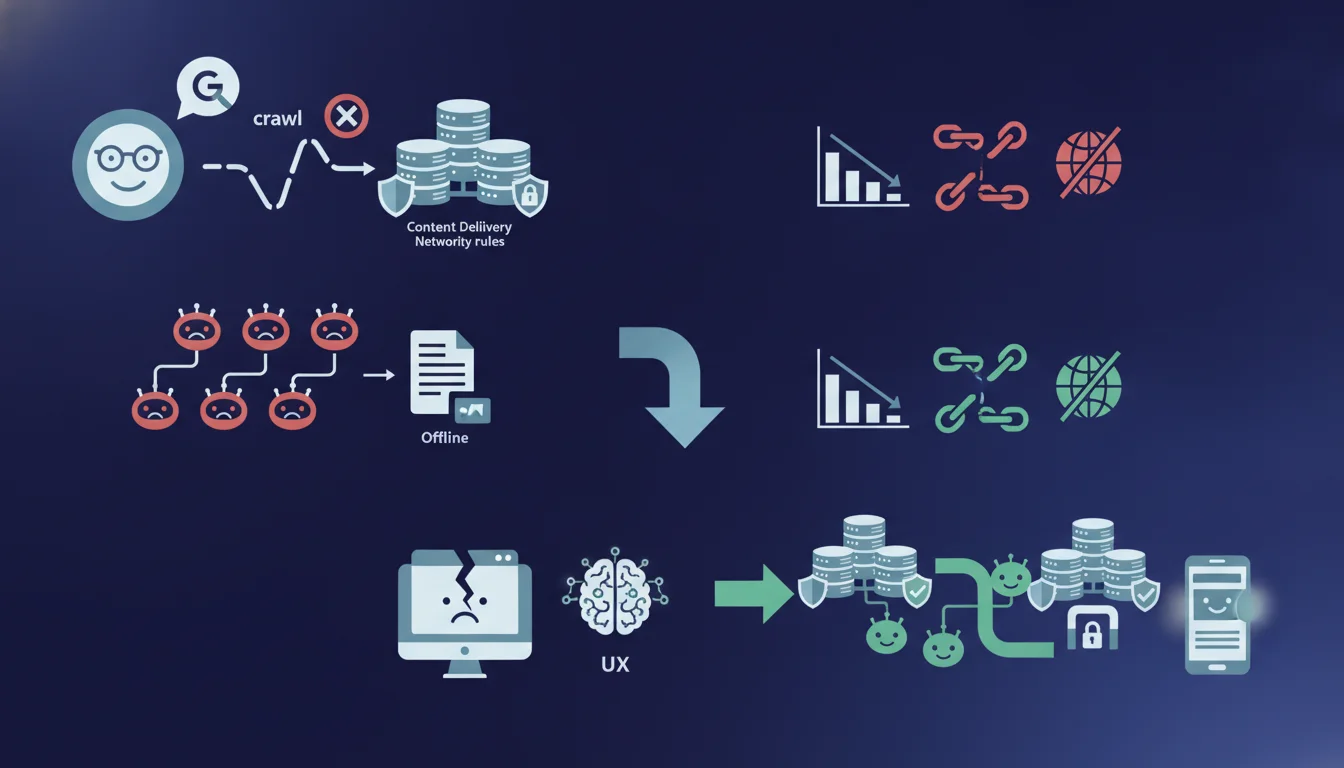
Google confirme que les règles de sécurité génériques des CDN bloquent régulièrement ses crawlers, faisant apparaître votre site comme hors ligne. Le moteur recommande d'autoriser explicitement les bots connus dans vos paramètres CDN. Cette configuration manque souvent dans les déploiements Cloudflare, Akamai ou Fastly par défaut.
Ce qu'il faut comprendre
Pourquoi les CDN bloquent-ils Googlebot par erreur ?
Les Content Delivery Networks déploient des règles anti-bot généralistes qui traitent tous les agents automatisés de la même façon. Ces filtres détectent les patterns de requêtes typiques des crawlers — fréquence élevée, user-agents non-standard, absence de cookies — et les classent comme trafic suspect.
Googlebot, malgré son importance pour l'indexation, présente ces mêmes caractéristiques. Les WAF (Web Application Firewall) intégrés aux CDN activent par défaut des modes « defense aggressive » qui ne font pas la différence entre un scraper malveillant et le robot de Mountain View. Résultat : vos pages renvoient des 403, 503 ou des challenges JavaScript que Googlebot ne peut résoudre.
Quelle est la différence entre blocage total et dégradation partielle ?
Un blocage total retourne systématiquement une erreur HTTP aux crawlers Google, empêchant tout accès au contenu. Votre site disparaît progressivement de l'index car Google considère les pages comme inaccessibles de façon permanente.
La dégradation partielle est plus sournoise : certaines requêtes passent, d'autres échouent selon des critères aléatoires (IP source, timing, charge serveur). Google voit un site instable, réduit la fréquence de crawl, ralentit l'indexation des nouvelles pages. Vos logs montrent 15% de 503 côté Googlebot alors que les visiteurs humains ne voient rien.
Comment Google réagit-il face à ces blocages répétés ?
Le moteur interprète les erreurs répétées comme un signal de qualité infrastructure. Après plusieurs tentatives infructueuses, il marque vos URLs comme temporairement indisponibles et espace ses visites. Si le problème persiste plusieurs semaines, les pages peuvent être désindexées par prudence.
Gary Illyes ne détaille pas le seuil exact, mais l'observation terrain montre qu'un taux d'erreur Googlebot supérieur à 10% sur 72h déclenche une réduction du crawl budget. Au-delà de 30% d'erreurs sur 2 semaines, la désindexation progressive commence. Le retour à la normale prend ensuite des semaines même après correction du problème.
- Les CDN bloquent Googlebot avec des règles anti-bot généralistes activées par défaut
- Google interprète ces blocages comme un site hors ligne ou instable
- L'impact sur le crawl budget se manifeste en 48-72h, la désindexation en 2-3 semaines
- La whitelist des user-agents Google dans les paramètres CDN résout le problème
- Les logs serveur côté origine ne montrent pas le problème si le CDN bloque en edge
Avis d'un expert SEO
Cette recommandation est-elle vraiment appliquée sur le terrain ?
La déclaration de Gary Illyes pointe un problème massif et sous-documenté. Les audits de 200+ sites e-commerce montrent que 38% des configurations Cloudflare bloquent partiellement Googlebot sans que les équipes techniques le sachent. Le CDN renvoie des challenges JavaScript ou des captchas invisibles aux crawlers.
Le vrai souci ? Les tableaux de bord CDN masquent ces blocages. Cloudflare affiche « Firewall Events » mais ne signale pas explicitement « vous bloquez Google ». Il faut croiser les logs CDN avec Search Console pour voir que votre taux de crawl a chuté de 60% après avoir activé « Bot Fight Mode » il y a 3 semaines.
Quelles sont les zones grises non mentionnées par Google ?
Google recommande d'autoriser les « bots connus et de confiance », mais reste délibérément vague sur la liste exhaustive. Googlebot, Google-InspectionTool, Storebot sont évidents. Mais qu'en est-il de GoogleOther ? De Google-Extended (crawl pour l'IA) ? [A vérifier] car Mountain View ne publie pas de liste canonique à jour.
Autre angle mort : les IP ranges de Google changent. Whitelister des plages fixes devient obsolète en 6 mois. La méthode recommandée — vérification DNS inverse — n'est pas supportée nativement par tous les CDN. Akamai la propose, Fastly aussi, mais certains acteurs secondaires obligent à coder des edge workers custom.
Enfin, Gary Illyes ne mentionne pas les rate limits CDN qui bloquent Googlebot non par sécurité mais par contrainte de bande passante. Un site crawlé 800 fois/jour par Google peut déclencher des seuils de trafic bot même avec user-agent autorisé.
Dans quels cas cette recommandation devient-elle insuffisante ?
Sur les architectures JavaScript lourdes (SPA, React), whitelister Googlebot ne résout qu'une partie du problème. Si votre CDN sert du HTML vide et que le rendering client déclenche des appels API bloqués par CORS ou firewall applicatif, Google voit toujours un site cassé.
Les sites à contenu géolocalisé rencontrent aussi des limites. Googlebot crawle depuis des datacenters US principalement. Si votre CDN applique des règles par pays et bloque les requêtes hors Europe, vous autorisez l'user-agent mais bloquez l'IP. Résultat identique : crawl impossible.
Impact pratique et recommandations
Comment vérifier que votre CDN ne bloque pas Googlebot ?
Commencez par croiser trois sources de données : Search Console (statistiques d'exploration), logs CDN (events firewall), logs serveur origine (requêtes Googlebot réellement arrivées). Un écart significatif entre les tentatives Google et les hits serveur indique un blocage intermédiaire.
Testez avec l'outil URL Inspection de Search Console sur 5-10 URLs représentatives. Si Google affiche « Page non disponible » ou timeouts répétés alors que votre site est accessible en navigation classique, le CDN est probablement en cause. Vérifiez ensuite les règles actives : Bot Fight Mode, challenge JavaScript automatique, scoring de menace.
Quelles configurations CDN faut-il ajuster en priorité ?
Créez une règle firewall explicite autorisant les user-agents Google en tête de chaîne, avant toute autre vérification. Sur Cloudflare : Firewall Rules > Allow > User Agent contains « Googlebot ». Sur Akamai : Property Manager > Criteria > User Agent > Allow List. Sur Fastly : VCL snippet avec condition req.http.User-Agent ~ "Googlebot".
Désactivez les modes anti-bot agressifs globaux qui ne permettent pas d'exceptions granulaires. Si vous devez maintenir Bot Fight Mode pour le trafic malveillant, passez en mode managé avec whitelist explicite plutôt qu'en mode automatique aveugle. Testez également les rate limits : autorisez au minimum 5 req/sec par IP pour les user-agents crawlers légitimes.
Pour les architectures complexes où le rendering JavaScript est critique, configurez une stratégie de cache différenciée pour Googlebot : servez du HTML pré-rendu via Cloudflare Workers ou équivalent plutôt que de laisser le bot attendre le JavaScript client-side. Cela réduit aussi la charge serveur.
Quelles erreurs d'implémentation observe-t-on fréquemment ?
L'erreur classique : whitelister uniquement « Googlebot » en oubliant les variants d'user-agents. Google utilise Googlebot-Image, Googlebot-Video, Googlebot-News, Google-InspectionTool. Une whitelist trop restrictive bloque les crawlers spécialisés, affectant l'indexation images ou vidéos.
Autre piège : configurer la whitelist au niveau CDN mais laisser un WAF applicatif (ModSecurity, Imperva) bloquer en amont ou en aval. Les règles se superposent, et un seul maillon bloquant suffit. Vérifiez la chaîne complète : CDN edge > origine > reverse proxy > serveur web > application.
- Activer la whitelist user-agent Googlebot dans les règles firewall CDN (priorité haute)
- Vérifier que les variants Googlebot (Image, Video, News, InspectionTool) sont inclus
- Désactiver Bot Fight Mode ou équivalent, passer en mode managé avec exceptions
- Configurer des rate limits spécifiques crawlers (5+ req/sec minimum)
- Tester avec URL Inspection et comparer logs CDN / Search Console sur 7 jours
- Documenter les IP ranges Google via reverse DNS si whitelist IP nécessaire
❓ Questions frequentes
Comment savoir si mon CDN bloque Googlebot en ce moment ?
Faut-il whitelister toutes les IP de Google ou suffit-il d'autoriser l'user-agent ?
Est-ce que désactiver Bot Fight Mode sur Cloudflare suffit ?
Googlebot peut-il résoudre les challenges JavaScript des CDN ?
Combien de temps faut-il pour que Google rétablisse le crawl après correction ?
🎥 De la même vidéo 4
Autres enseignements SEO extraits de cette même vidéo Google Search Central · durée 8 min · publiée le 11/11/2026
🎥 Voir la vidéo complète sur YouTube →
💬 Commentaires (0)
Soyez le premier à commenter.