
Declaration officielle
Autres déclarations de cette vidéo 5 ▾
- 4:58 Les résultats de recherche internes tuent-ils votre budget de crawl ?
- 10:11 Faut-il vraiment bloquer les pages de résultats de recherche internes avec robots.txt ?
- 11:20 L'outil de suppression Search Console bloque-t-il vraiment le crawl de vos pages ?
- 17:03 Les pages de résultats de recherche interne sont-elles toujours considérées comme du spam par Google ?
- 20:49 Les pages de résultats internes peuvent-elles vraiment nuire au classement Google ?
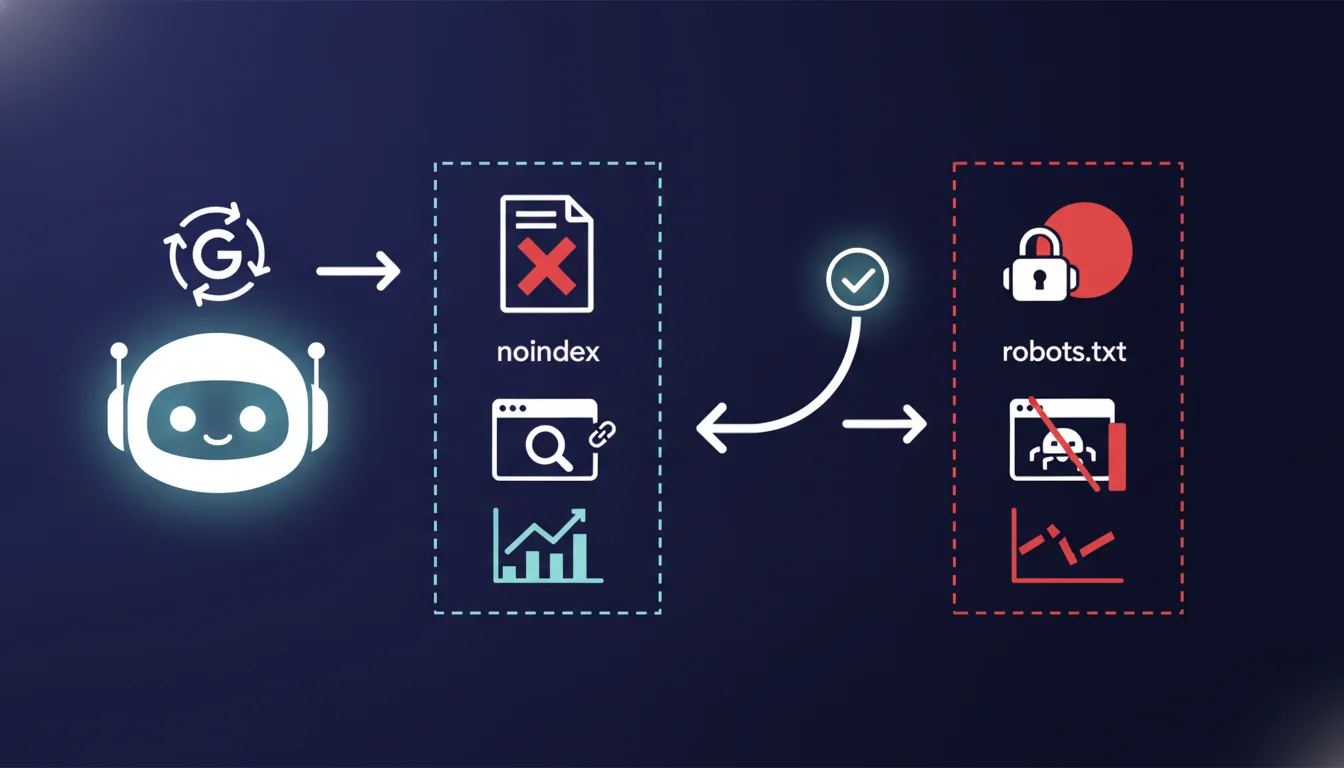
Google recommande le noindex. Pour empêcher l'indexation des pages de résultats de recherche interne, cette directive est préférée au robots.txt : les crawlers continuent d'explorer ces URLs, mais celles-ci ne remontent plus dans les SERP. Reste l'enjeu du crawl budget, qu'il faut préserver sur ces pages. Sans perdre le bénéfice du maillage interne qu'elles génèrent.
Ce qu'il faut comprendre
Pourquoi Google déconseille-t-il robots.txt pour les pages de résultats internes ?
La différence entre bloquer l'exploration et bloquer l'indexation n'est pas une simple subtilité technique : avec robots.txt, vous coupez purement et simplement l'accès à Googlebot. Le crawler ne voit rien. Il ne suit aucun lien et ne comprend pas comment cette zone de votre site s'articule.
Les pages de résultats de recherche interne (type ?s= ou ?search=) posent un problème particulier, puisqu'elles produisent souvent des milliers d'URLs combinatoires qui gonflent l'index pour rien. Sauf qu'en bloquant leur exploration via robots.txt, vous perdez aussi tous les liens internes qu'elles pointent vers vos vraies fiches produits ou vos contenus.
En quoi noindex est-il plus efficace pour ce cas d'usage ?
Avec noindex, Google peut explorer la page, en lire la structure, suivre les liens. Il n'a simplement pas le droit de la stocker dans son index. Pour des pages de résultats internes, c'est précisément le comportement attendu : ce sont des hubs de navigation, sans aucune valeur comme landing page organique.
Via ces liens, Googlebot crawle l'URL, repère les chemins vers vos articles ou vos fiches produits, et transmet du PageRank interne. La page de résultats, elle, ne polluera jamais vos SERP et ne viendra pas cannibaliser vos pages de catégories.
Quelle est la limite de cette approche ?
Reste le volume. Quand un moteur de recherche interne produit 50 000 URLs combinatoires, en autoriser l'exploration peut engloutir votre crawl budget à toute vitesse, Google consacrant du temps à ces pages plutôt qu'à vos contenus stratégiques.
D'où une solution hybride, fréquente : noindex sur les pages qui alimentent le maillage, robots.txt sur les variations absurdes (tri par prix croissant + filtres multiples + pagination profonde). La frontière reste floue, et elle dépend de votre architecture.
- Robots.txt bloque exploration : aucun accès au contenu, aucun transfert de PageRank via les liens internes
- Noindex bloque indexation : exploration autorisée, liens suivis, mais page exclue de l'index Google
- Pages de résultats internes : valeur nulle en SERP, mais utiles comme hub de navigation interne
- Risque crawl budget : autoriser l'exploration de milliers d'URLs peut saturer le temps disponible du crawler
- Approche hybride : noindex sur les URLs utiles, robots.txt sur les variations inutiles
Avis d'un expert SEO
Cette recommandation est-elle cohérente avec les observations terrain ?
Oui, avec une réserve sur le crawl budget : sur des sites de moins de 10 000 pages, ouvrir l'exploration des résultats de recherche interne via noindex donne de bons résultats. Google crawle régulièrement, suit les liens. Le maillage interne reste fluide.
Sur des sites e-commerce de 100 000 références avec des dizaines de filtres combinables, en revanche, j'ai vu Google consacrer 60 % de son temps de crawl à des URLs de résultats sans valeur. La Search Console montre l'explosion des pages explorées non indexées pendant que des pages stratégiques ne passent au crawl qu'une fois par mois. [A vérifier] dans votre propre contexte avant de généraliser.
Quand faut-il quand même privilégier robots.txt ?
Quand le volume d'URLs générées devient ingérable. Si votre moteur de recherche interne produit des combinaisons infinies (facettes multiples, tri, pagination), vous n'avez pas le luxe de laisser Google tout explorer. Le noindex n'y change rien : crawler ces pages bouffe déjà votre crawl budget.
Autre cas de figure, les sites qui souffrent d'une duplication massive. Quand vos pages de résultats affichent le contenu d'une catégorie déjà existante, le noindex ne suffit pas toujours. J'ai vu Google continuer à indexer malgré la balise, simplement parce que le signal entrait en contradiction avec d'autres indices : canonical mal posé, liens entrants externes.
Quelle nuance apporter sur le transfert de PageRank ?
Google suit les liens depuis une page noindex, c'est confirmé. Le poids transmis, lui, dépend de la fréquence de crawl et de la profondeur de la page dans l'arborescence. Une page de résultats accessible en 2 clics depuis la home transmet du jus. Une URL enfouie à 8 clics, crawlée tous les 3 mois, n'apporte rien.
L'erreur classique consiste à voir dans le noindex une solution miracle, qui préserverait 100 % du maillage interne sans le moindre impact sur le crawl. Si Google crawle 500 pages de résultats par jour au lieu de 500 fiches produits, vos contenus stratégiques y perdent en fraîcheur d'indexation. Arbitrage permanent.
Impact pratique et recommandations
Que faut-il faire concrètement sur un site avec moteur de recherche interne ?
Premier réflexe : auditer le volume d'URLs générées. Direction la Search Console, section Couverture, avec un filtre sur vos patterns de recherche interne (?s=, /search/, etc.). Moins de 500 URLs explorées ? Le noindex suffit largement. Au-delà de 5 000, il faut segmenter, avec du noindex sur les requêtes à fort trafic interne et du robots.txt sur le reste.
Côté technique, la balise <meta name='robots' content='noindex, follow'> se place dans le head de vos pages de résultats. Le 'follow' compte beaucoup : il autorise Google à suivre les liens. Si votre moteur génère des PDFs ou d'autres fichiers non-HTML, ajoutez un X-Robots-Tag: noindex, follow dans vos headers HTTP.
Comment éviter que noindex explose votre crawl budget ?
Prévoyez un crawl delay adapté, ou passez par les paramètres d'URL dans la Search Console : Google les annonce comme obsolètes, mais ils limitent encore l'exploration. Surveillez le rapport 'Statistiques d'exploration' chaque semaine. Un temps de téléchargement qui grimpe, un nombre de pages crawlées par jour qui explose, et le signal est mauvais.
Autre levier : la pagination raisonnée. Si votre moteur de recherche affiche 50 pages de résultats pour une requête générique, limitez à 5 pages maximum et basculez le reste en noindex + nofollow, ou bloquez via robots.txt. Pourquoi Google irait-il crawler la page 47 d'une recherche sur 'chaussures' ?
Quelles erreurs faut-il absolument éviter ?
Jamais de robots.txt et de noindex sur la même URL. Une URL bloquée par robots.txt empêche Google de voir la balise noindex, et elle peut rester dans l'index avec un message 'Bloquée par robots.txt'. Le pire des deux mondes : aucun crawl, mais une présence fantôme dans les SERP.
Deuxième erreur : oublier le canonical. Une page de résultats qui affiche les mêmes produits qu'une catégorie classique doit pointer vers cette catégorie via canonical, en plus du noindex. Sans ça, Google se perd entre des signaux contradictoires et peut ignorer votre noindex.
- Auditer le volume d'URLs de recherche interne dans la Search Console
- Implémenter noindex, follow sur les pages de résultats stratégiques
- Bloquer via robots.txt les variations inutiles (tri + filtres + pagination profonde)
- Surveiller le crawl budget hebdomadaire dans les Statistiques d'exploration
- Ne jamais combiner robots.txt et noindex sur la même URL
- Ajouter un canonical vers la catégorie équivalente si duplication de contenu
❓ Questions frequentes
Peut-on utiliser noindex sur des pages de catégories classiques ?
Googlebot suit-il vraiment les liens depuis une page noindex ?
Que se passe-t-il si on bloque une URL par robots.txt alors qu'elle a déjà un noindex ?
Le X-Robots-Tag HTTP est-il équivalent à la meta noindex ?
Comment vérifier que Google respecte bien mon noindex ?
🎥 De la même vidéo 5
Autres enseignements SEO extraits de cette même vidéo Google Search Central · durée 28 min · publiée le 30/07/2026
🎥 Voir la vidéo complète sur YouTube →
💬 Commentaires (0)
Soyez le premier à commenter.